뎁스노트 / 뎁스추천
뎁스추천
에디터가 고른 글과, 반응이 좋은 글을 모았습니다.


자율주행용 VLA 모델이 중국에서는 작동하지만 유럽에서는 실패하는 이유
상하이에서 배운 VLA가 슈투트가르트에서도 통하려면, 학습 데이터부터 달라져야 한다중국 밖에서 VLA 모델의 성능이 떨어지는 이유Reddit에서 언급된 사례를 보면 일부 중국 로보택시는 약 3,000 TOPS의 연산 성능을 갖춘 반면, 일부 유럽 차량은 약 750 TOPS 수준입니다. 숫자만 보면 중국 차량이 훨씬 강력해 보입니다. 하지만 연산 성능이 높다고 해서 중국 도로를 중심으로 학습한 VLA 모델이 유럽이나 북미에서도 그대로 잘 작동하는 것은 아닙니다.VLA 모델은 인지와 추론, 행동을 하나의 흐름으로 연결해 자율주행 성능을 끌어올립니다. 하지만 아무리 연산 성능이 좋아도 학습 데이터가 특정 지역에 치우쳐 있다면 그 한계를 컴퓨팅 파워만으로 메우기는 어렵습니다.학습 데이터에 충분한 지리적 다양성이 없다면, 모델은 익숙한 지역을 벗어나는 순간 성능이 흔들릴 수 있습니다. 이 글에서는 왜 이런 문제가 생기는지, 그리고 데이터 수집 단계에서 어떻게 보완할 수 있는지 살펴봅니다.VLA 학습에서 ‘어디서 수집한 데이터인가’가 중요한 이유VLA(Vision-Language-Action) 모델은 학습할 때 자주 본 환경에서는 좋은 성능을 낼 수 있습니다. 하지만 다른 지역에 배포되면 이야기가 달라질 수 있습니다.자율주행에서는 데이터의 지리적 범위가 곧 일반화 성능과 연결됩니다. 모델이 한 번도 보지 못한 도로와 교통 환경에서 얼마나 잘 대응할 수 있는지가 여기에 달려 있기 때문입니다.VLA 모델에서 지리적 다양성이 특히 중요한 이유VLA 모델은 다양한 멀티모달 관측 데이터를 보면서 ‘어떻게 운전해야 하는지’를 배웁니다. 도로의 형태, 차량과 보행자의 움직임, 날씨와 인프라가 운전 판단에 어떤 영향을 주는지 모두 학습 데이터에서 익힙니다.세계 각국의 정지 표지판이미지 요약: 국가마다 정지 표지판의 모양과 표기 방식이 다르며, 같은 ‘정지’ 의미도 지역별 시각적 표현이 달라질 수 있습니다.여기서 시장별 차이를 생각해 보면 문제가 더 분명해집니다. 도로 구조와 차선 표시, 교통 표지판, 차량 종류, 보행자 행동, 날씨, 인프라는 중국과 유럽, 미국에서 상당히 다를 수 있습니다.세계 각국의 좌측통행과 우측통행이미지 요약: 국가에 따라 우측통행과 좌측통행이 나뉘며, 이 차이는 차량의 장면 해석과 경로 예측에 직접 영향을 줍니다.심지어 어느 쪽 차선으로 달리는지도 국가마다 다릅니다. 어떤 나라는 우측통행을 하고, 어떤 나라는 좌측통행을 합니다. 이런 차이는 모델이 장면을 해석하고 다음 주행 경로를 예측하는 방식에 직접 영향을 줍니다.중국, 독일, 캘리포니아처럼 몇몇 지역에 집중된 데이터 수집 플릿만으로는 다른 시장의 도로 환경까지 자연스럽게 커버할 수 없습니다. 그래서 VLA 학습 파이프라인에서는 ‘지리적 커버리지’를 별도의 핵심 데이터 축으로 관리해야 합니다.중요한 것은 샘플 수를 무조건 늘리는 것이 아닙니다. 모델이 실제로 운행될 국가와 환경이 데이터셋 안에 충분히 반영되어 있어야 합니다.롱테일 시나리오 역시 지리적이다자율주행에서 어려운 ‘롱테일’ 상황도 지역마다 다르게 나타납니다. 어떤 곳에서는 눈 덮인 도로가 흔하고, 다른 곳에서는 복잡한 회전교차로가 많습니다. 특정한 보행자 행동이나 교통 패턴이 특정 도시에서 유독 자주 나타날 수도 있습니다.회전교차로를 많이 사용하는 국가들이미지 요약: 국가별 회전교차로 보급 수준에는 큰 차이가 있습니다. 프랑스·스페인·영국/아일랜드 등은 미국보다 훨씬 높은 밀도를 보입니다.같은 지역의 영상을 계속 늘리는 것만으로는 지리적 다양성이 생기지 않습니다. 필요한 것은 국가, 기후, 도로 유형, 인프라별로 부족한 영역을 찾아 의도적으로 데이터를 채우는 방식입니다.이런 지리적 사각지대는 시나리오, 센서, 어노테이션의 공백과 함께 점검해야 합니다. 그렇지 않으면 데이터 규모나 지표만 봤을 때는 충분히 학습된 모델처럼 보여도, 실제 배포 시장에서는 예상보다 쉽게 흔들릴 수 있습니다.물리적 차량 플릿만으로 모든 지역을 커버하기 어려운 이유카메라와 LiDAR, 레이더처럼 동기화된 센서 데이터를 얻으려면 실제 차량 플릿이 여전히 중요합니다. 다만 새로운 지역의 커버리지를 빠르게 넓히는 방법으로는 항상 가장 효율적이지는 않습니다.차량 플릿 데이터의 지리적 확장성 문제관심 있는 시장마다 차량 플릿을 직접 운영하려면 차량뿐 아니라 현지 인력, 인프라, 규제 승인까지 필요합니다. 특히 유럽에서는 데이터법(Data Act) 같은 규제 환경도 고려해야 합니다. 국가를 넓혀 갈수록 비용과 시간은 빠르게 늘어납니다.또 하나의 문제는 플릿 데이터가 회사가 이미 운영 중인 지역에 자연스럽게 쏠린다는 점입니다. 몇 개 국가에서 수백만 건의 주행 샘플을 모아도 다른 시장의 데이터는 여전히 부족할 수 있습니다. 결국 ‘데이터가 많은 곳’과 ‘모델이 실제로 달려야 하는 곳’ 사이에 격차가 생깁니다.특정 장면 하나를 확보하기 위해 차량을 보내는 것도 비효율적일 수 있습니다. 예를 들어 유럽의 회전교차로 데이터가 부족하다는 사실을 뒤늦게 발견했다면, 필요한 사례를 모으기 위해 차량을 배치하고 운행하는 데 몇 주에서 몇 달이 걸릴 수 있습니다.공개 웹 데이터는 플릿 데이터의 빈틈을 메울 수 있다윤리적이고 합법적인 방식으로 수집한 공개 웹 데이터는 이런 지리적 공백을 빠르게 파악하는 데 유용합니다. 거리 이미지, 주행 영상, 지도 같은 자료를 활용하면 기존 플릿 데이터에 없는 도로 환경을 먼저 확인하고, 어디에 추가 수집이 필요한지 판단할 수 있습니다.예를 들어 Bright Data는 POV 주행 영상을 포함한 YouTube 영상이나 Google Maps Street View 등 여러 공개 웹 소스에서 멀티모달 AI 데이터를 수집할 수 있도록 지원합니다.슈투트가르트의 4K 30분짜리 YouTube 주행 POV 영상 (출처: 유튜브 @RelaxingRoads4K 채널)이미지 요약: 실제 도심 주행 영상을 활용하면 현지 도로 구조, 표지판, 교통 흐름 같은 시각 정보를 확인할 수 있습니다.이렇게 확보한 데이터는 실제 차량을 추가로 투입하기 전에 새로운 지역을 탐색하고, 어떤 환경이 부족한지 파악하는 데 활용할 수 있습니다. 결과적으로 더 넓은 지역을 반영한 AI 학습 데이터셋을 설계하기 쉬워집니다.물론 웹 데이터가 실제 차량에서 얻는 동기화된 카메라, LiDAR, 레이더 데이터를 대신할 수는 없습니다. 역할은 ‘대체’가 아니라 ‘보완’입니다. 기존 플릿 데이터로 놓치고 있는 지역과 시나리오를 찾고, 학습 데이터의 폭을 넓히는 데 활용하는 것입니다.여러 지역에서 통하는 VLA 데이터셋은 어떻게 만들까?모든 국가에서 똑같은 양의 데이터를 모을 필요는 없습니다. 중요한 것은 현재 데이터셋에서 어떤 지역과 환경이 부족한지 파악하고, 그 부분을 의도적으로 채우는 것입니다. 실제 차량 플릿이든 웹 데이터든 목적은 같습니다.1. 먼저 ‘어디에서 달릴 모델인지’부터 정리하기먼저 모델이 실제로 배포될 국가와 도시를 정리합니다. 그다음 기존 데이터셋과 비교해 어떤 도로, 기후, 교통 패턴, 주행 조건이 부족한지 확인합니다. 핵심은 ‘다양성을 높이자’는 막연한 목표가 아니라, 어떤 환경이 얼마나 부족한지를 측정 가능한 지표로 바꾸는 것입니다.예를 들어 유럽 배포를 준비한다면 도로 구조가 다른 국가, 드문 기상 조건, 독특한 표지판, 지역 특유의 운전 관행이 있는 곳의 샘플을 우선적으로 보강할 수 있습니다.2. 플릿이 없는 시장은 웹 데이터로 먼저 탐색하기부족한 지역을 파악했다면, 아직 차량 플릿이 없는 시장은 웹 데이터로 먼저 탐색할 수 있습니다. 지역별로 분산된 수집 파이프라인을 활용해 도로 환경과 시각 자료를 확보하면, 실제 차량을 투입하기 전에 필요한 범위를 좁힐 수 있습니다.활용할 수 있는 소스로는 YouTube, Bilibili, Vimeo의 주행 영상과 Google Maps Street View 등이 있습니다.Bright Data로 수집할 수 있는 슈투트가르트 도로의 Google Maps Street View 스크린샷 예시이미지 요약: Street View 같은 거리 이미지는 플릿이 없는 지역의 도로 형태와 인프라를 사전 탐색하는 데 활용할 수 있습니다.이런 데이터를 여러 국가에서 안정적으로 수집하려면 지역 타기팅 범위가 넓은 프록시 인프라가 필요합니다. Bright Data는 195개국에서 4억 개 이상의 프록시 IP를 제공하며, 국가와 주, 도시, 위도·경도 단위까지 세밀하게 지역을 지정할 수 있습니다.수집 파이프라인을 처음부터 직접 만들고 싶지 않다면 데이터셋 제공업체를 활용하는 방법도 있습니다. Bright Data는 AI 학습에 활용할 수 있는 페타바이트 규모의 데이터셋 마켓플레이스를 운영합니다.3. 모은 데이터를 실제 학습 신호로 바꾸기웹 데이터는 많이 모으는 것보다 ‘왜 필요한가’가 더 중요합니다. 도로 유형, 날씨, 교통 상황, 인프라처럼 모델 성능과 직접 연결되는 기준으로 데이터를 분류하고 필터링해야 학습에 의미 있는 신호가 됩니다.이때 지역 정보와 데이터 출처도 함께 보존해야 합니다. 그래야 어떤 데이터가 어디에서 왔는지 추적할 수 있고, 자체 센서 데이터와 비교해 실제로 어떤 지역이 부족한지도 판단할 수 있습니다. 이후 물리적 차량 수집은 정말 필요한 곳에 집중하면 됩니다.글로벌 배포를 위한 VLA 데이터 워크플로이제 중요한 것은 이런 과정을 한 번의 프로젝트가 아니라 반복 가능한 워크플로로 만드는 것입니다.1단계: 기존 VLA 학습 데이터셋 점검먼저 학습·검증 데이터셋을 국가, 도시, 기후, 도로 유형, 시나리오별로 나눠 분포를 확인합니다. 데이터셋이 아무리 커도 실제로는 몇몇 지역에만 몰려 있을 수 있습니다.그다음 대표성이 부족한 시장을 찾습니다. 비슷한 장면만 반복해 데이터 양을 늘리는 것과 실제 환경의 다양성을 넓히는 것은 구분해야 합니다.2단계: 외부 데이터로 지리적 대표성 부족 보완대표성이 부족한 시나리오가 보이면 관련 도로 장면, 주행 영상, 거리 이미지, 환경 데이터를 웹에서 찾아 보강합니다. 지리적으로 분산된 프록시 인프라를 활용하면 탐색 단계부터 차량을 직접 보내지 않고도 필요한 데이터를 확보할 수 있습니다.야간 도로, 겨울철 주행, 낯선 교차로 구조처럼 구체적인 질문에 답할 수 있는 데이터를 우선적으로 모으는 것이 좋습니다. 이렇게 확보한 외부 데이터를 자체 센서 데이터와 결합하면 지역별 빈틈을 훨씬 명확하게 메울 수 있습니다.3단계: 분석 결과를 모델 개발에 다시 반영모델 평가 결과를 다시 데이터 수집에 연결합니다. 어떤 지역과 환경에서 성능이 떨어지는지 확인하고, 그 조건을 겨냥한 샘플을 학습·검증 세트에 추가합니다. 이후 실제로 성능이 개선됐는지 다시 측정합니다.배포 지역이 늘어날 때마다 이 과정을 반복해야 합니다. 지리적 커버리지는 새 시장에 진입할 때 한 번 확인하고 끝내는 항목이 아니라, 계속 추적해야 하는 모델 품질 지표에 가깝습니다.다음 VLA 학습 전에 확인할 체크리스트다음 학습을 시작하기 전에 아래 항목만 확인해도 데이터 수집 우선순위를 훨씬 구체적으로 정할 수 있습니다.☐ 다음 VLA 또는 ADAS(첨단 운전자 보조 시스템) 모델 학습 전에 학습 세트의 지리적 분포를 점검한다.☐ 차량 플릿의 도로 및 환경 커버리지가 가장 취약한 배포 시장 5곳을 정리한다.☐ 각 시장에서 중요하지만 대표성이 부족한 시나리오 3개를 선정하고, 어떤 웹 소스에서 관련 데이터를 확보할 수 있는지 파악한다.☐ 한 시장을 대상으로 지리 분산형 데이터 수집을 테스트하고 기존 플릿 데이터의 커버리지와 비교한다.☐ 결과를 바탕으로 물리적 데이터 수집이 필요한 영역과 외부 웹 데이터로 지역 간 AI 학습 데이터셋을 개선할 수 있는 영역을 구분한다.☐ 수집한 데이터를 전체 VLA 학습 데이터 파이프라인에 연결하고 지리적 메타데이터와 출처 정보를 보존한다.결론결국 VLA가 새로운 시장에서도 잘 작동하느냐는 연산 성능만의 문제가 아닙니다. 학습 데이터가 실제 배포 지역을 얼마나 잘 반영하고 있는지가 핵심입니다.신뢰할 수 있는 VLA 학습 파이프라인이라면 데이터의 지리적 분포를 점검하고, 부족한 시나리오를 찾아 보완한 뒤, 다시 학습하고 목표 시장에서 검증하는 과정이 반복되어야 합니다.Bright Data는 페타바이트 규모의 지리 분산형 데이터를 제공해 모든 지역에 직접 차량 플릿을 배치하지 않고도 자율주행 데이터의 지리적 다양성을 넓힐 수 있도록 지원합니다. 글로벌 학습 파이프라인을 구축하려는 팀이라면 Bright Data의 비디오 데이터 인프라를 무료로 테스트해 볼 수 있습니다.
156
2
2
AI 코딩 도구도 결국 ‘생태계 싸움’이 되는 걸까
Cursor에서 OpenAI 모델을 사용하지 못하게 될 수도 있다는 소식을 접했다.지난 8월 Cursor가 SpaceX에 인수됐고, 이후 OpenAI는 Cursor에 제공하던 모델 공급 계약을 종료하겠다는 입장을 밝혔다. 현재 이야기되고 있는 전환 시점은 11월 12일이다.당장 Cursor에서 GPT를 사용할 수 없어진다는 이야기는 아니다. 아직 일정도 최종 확정된 것은 아니고, 개인 OpenAI API 키를 이용하는 방법도 남아 있다.그래도 이번 일을 보면서 한 가지 생각이 들었다.AI 코딩 도구의 경쟁이 점점 단순한 ‘도구의 기능 경쟁’이 아니게 되고 있다는 것이다.몇 년 전만 해도 AI 코딩 도구를 선택할 때는 어떤 에디터가 편한지, 자동완성이 얼마나 좋은지 정도가 중요한 기준이었다. 이후 Claude, GPT, Gemini 같은 여러 모델을 골라 사용할 수 있게 되면서 좋은 모델을 얼마나 빠르게 붙여주는지도 중요해졌다.그런데 이제 상황이 조금씩 달라지고 있다.OpenAI에는 Codex가 있고, Anthropic에는 Claude Code가 있다. Cursor 역시 자체 모델을 만들고 있으며 SpaceX와 결합하면서 모델 개발에 훨씬 적극적으로 나설 수 있는 환경이 됐다.결국 각 회사가 단순히 ‘좋은 모델 하나’를 만드는 것을 넘어 모델과 에이전트, 개발 환경을 하나의 생태계로 묶으려는 방향으로 움직이고 있다.이렇게 되면 개발자 입장에서도 고민할 부분이 생긴다.예를 들어 지금까지 Cursor에서 Claude와 GPT를 번갈아 쓰면서 작업했다면 도구와 모델은 어느 정도 독립적인 존재였다. 하지만 앞으로 각 회사의 모델이 자기 회사의 에이전트와 개발 환경에서 가장 잘 작동하도록 발전한다면 이런 구분은 점점 흐려질 수 있다.예전에는 어떤 IDE를 사용할지가 선택의 문제였다면, 앞으로는 어떤 AI 개발 생태계 안에서 일할지를 선택해야 할 수도 있다.그렇다고 지금부터 특정 도구를 피할 필요까지는 없다고 생각한다.오히려 반대다.Cursor를 쓰더라도 필요하면 Claude Code를 사용할 수 있고, Codex도 사용할 수 있는 식으로 특정 도구 하나에 작업 방식을 지나치게 맞추지 않는 것이 더 중요해질 것 같다.AI 개발 도구는 아직 변화가 너무 빠르다. 오늘 가장 좋은 조합이 몇 달 뒤에도 그대로일 가능성은 높지 않다.그래서 지금은 ‘어떤 도구가 최고인가’를 찾는 것보다, 도구가 바뀌어도 쉽게 옮겨갈 수 있는 개발 습관을 만드는 편이 더 중요하지 않을까 싶다.이번 Cursor와 OpenAI의 변화도 단순히 GPT가 Cursor에서 빠지느냐 마느냐보다 그 점에서 더 흥미롭게 느껴진다.AI 코딩 경쟁은 이제 모델의 성능 경쟁을 넘어, 개발자가 어느 생태계에서 일하게 될지를 놓고 벌이는 경쟁으로 넘어가고 있는 것 같다.
268
0


5분만에 이해하는 OpenClaw
최근 개발자 커뮤니티에서 OpenClaw라는 이름이 자주 언급되고 있습니다.“AI 에이전트”, “자동 업무 수행”, “로컬 실행” 같은 키워드와 함께 등장하는데,정확히 무엇인지 한 번에 이해하기는 쉽지 않습니다.이 글에서는 OpenClaw가 무엇인지, 왜 주목받는지, 그리고 어떤 점을 조심해야 하는지를 5분 안에 이해할 수 있도록 정리해보겠습니다.OpenClaw 한 줄 정리OpenClaw는 AI가 사용자의 컴퓨터를 직접 조작해서 일을 대신 수행하도록 하는 오픈소스 에이전트입니다.즉,사람이 직접 클릭하고키보드를 입력하고프로그램을 실행하던 작업을→ AI가 대신 수행하는 구조입니다.기존 AI와 무엇이 다른가기존의 ChatGPT나 코딩 AI는 주로 다음 역할을 했습니다.질문에 답변코드 생성문서 작성아이디어 제공즉, “생각”을 도와주는 AI였습니다.반면 OpenClaw는프로그램 실행파일 생성 및 이동브라우저 조작반복 작업 자동화같이 “행동”을 대신하는 AI입니다.쉽게 이해하는 예시예를 들어 이런 요청을 한다고 가정해봅시다.“오늘 올라온 개발 뉴스 5개를 찾아서 요약하고, 블로그에 초안까지 작성해줘.”기존 방식:사람이 뉴스 검색내용 읽기요약 작성블로그에 업로드OpenClaw 방식:AI가 브라우저 실행뉴스 사이트 접속기사 수집요약 작성블로그 초안 파일 생성→ 사람이 한 번 지시하면 나머지는 AI가 수행OpenClaw가 주목받는 이유1. 반복 업무 자동화파일 정리데이터 입력보고서 생성테스트 실행같은 반복 작업을 자동으로 처리할 수 있습니다.2. 개인용 AI 비서의 현실화예전에는 AI 비서가 말만 하는 수준이었다면,이제는 실제로 컴퓨터를 조작하면서 일을 처리합니다.예를 들어:이메일 정리일정 생성문서 작성파일 다운로드 및 정리같은 작업을 자동으로 수행할 수 있습니다.3. 로컬 실행 가능많은 AI 서비스는 클라우드 기반입니다.하지만 OpenClaw는:로컬 PC에서 실행 가능오픈소스직접 수정 가능→ 개인 환경에 맞춘 AI 자동화가 가능합니다.개발자에게 의미하는 변화OpenClaw 같은 도구가 보편화되면 다음과 같은 변화가 예상됩니다.1. 단순 작업의 자동화서버 배포로그 확인테스트 실행코드 정리→ 반복 작업은 AI가 수행2. 개발자의 역할 변화앞으로 개발자는:코드를 직접 치는 사람→ AI에게 일을 시키는 사람으로 역할이 바뀔 가능성이 큽니다.즉,“무엇을 만들 것인가”“어떻게 자동화할 것인가”를 설계하는 능력이 더 중요해집니다.실제로 어떤 작업이 가능한가현재 OpenClaw로 가능한 대표적인 작업은 다음과 같습니다.파일 생성 및 수정폴더 정리프로그램 실행브라우저 자동 조작반복 업무 자동화간단한 개발 작업 수행아직 완전히 안정적인 단계는 아니지만,“AI가 실제 업무를 수행하는 시대”의 시작점으로 평가받고 있습니다.가장 중요한 문제: 보안 이슈OpenClaw 같은 AI 에이전트는 매우 강력하지만,동시에 보안 위험도 매우 큽니다.1. 컴퓨터 전체 접근 가능AI가:파일 삭제프로그램 실행인터넷 접속계정 정보 접근을 할 수 있기 때문에잘못된 명령이나 악성 프롬프트가 들어오면 큰 피해가 발생할 수 있습니다.2. 프롬프트 인젝션 위험예를 들어:웹사이트에 숨겨진 악성 지시문이메일에 포함된 공격 프롬프트같은 것이 AI에게 전달되면,AI가 사용자의 의도와 다르게:파일 업로드계정 정보 전송악성 코드 실행을 할 가능성도 있습니다.3. 권한 관리가 핵심AI 에이전트를 사용할 때는 반드시:테스트용 계정 사용중요한 폴더 접근 제한관리자 권한 금지네트워크 접근 제한같은 샌드박스 환경에서 실행하는 것이 안전합니다.결론OpenClaw는 단순한 AI 챗봇이 아니라,“실제로 컴퓨터를 대신 사용하는 AI”라는 점에서 큰 변화를 의미합니다.앞으로는:AI에게 일을 맡기고결과를 검토하는형태의 업무 방식이 점점 늘어날 가능성이 큽니다.다만, 강력한 만큼 보안 관리와 권한 통제는 필수입니다.한 줄 정리OpenClaw는 AI가 생각만 하는 것이 아니라, 실제로 컴퓨터를 조작해 일을 대신하는 오픈소스 에이전트다.다만, 강력한 만큼 보안 관리가 매우 중요하다.
1.8K
1
0

macOS 26 “Tahoe”에서 Electron 기반 앱이 느려지는 문제
최근 macOS 26(Tahoe)로 업데이트한 사용자들 사이에서 Electron 기반 앱의 성능 저하 문제가 보고되고 있습니다.대표적으로 Cursor, Postman, Dropbox, Notion, Slack 등의 앱이 느려지거나 UI 반응이 둔해지는 현상이 나타나고 있습니다.🔍 문제의 원인이 문제는 macOS 자체의 변화라기보다 Electron 런타임의 호환성 이슈에서 비롯된 것으로 알려져 있습니다.Electron은 크로스 플랫폼 데스크톱 앱을 만들 때 사용하는 프레임워크로, Chromium과 Node.js 위에서 작동합니다.Tahoe 업데이트 이후 일부 Electron 버전(특히 v30 이하)에서 렌더링 성능 저하 및 UI 지연 현상이 발생하고 있으며, 이는 내부 그래픽 API나 윈도우 컴포지팅 방식의 변경과 관련이 있는 것으로 추정됩니다.🧩 해결 방법: Electron 패치 업데이트다행히도 문제를 해결할 수 있는 패치가 이미 Electron 측에서 배포되었습니다.즉, 앱 개발자가 Electron의 최신 버전(예: v31 이상)을 적용하여 다시 빌드하면 대부분의 성능 문제가 해결됩니다.하지만 일반 사용자는 이 패치를 직접 적용할 수 없습니다.각 앱의 개발자 또는 회사가 Electron 버전을 업데이트한 새 버전을 릴리즈해야만 문제가 해결됩니다.⏳ 현재 패치 상황 확인하기현재 어떤 앱이 패치를 적용했는지, 어떤 앱이 여전히 느린 상태인지 정리된 사이트가 있습니다:👉 https://avarayr.github.io/shamelectron/이 사이트는 macOS 26 “Tahoe” 환경에서 Electron 앱들의 패치 진행 상황을 실시간으로 추적합니다.예를 들어 “Fixed” 상태면 이미 해결된 앱, “Not fixed”면 아직 느려진 상태로 남아 있는 앱을 의미합니다.💬 개발자 입장에서의 불편함저 역시 개발자로서 현재 이 문제를 체감하고 있습니다.예를 들어 Cursor, Postman, Dropbox 같은 주요 개발 툴이 Electron 기반으로 만들어져 있는데, 이들 대부분이 아직 패치가 적용되지 않아 실행 속도가 평소보다 느리고 UI 반응이 버벅이는 상황입니다.이는 단순히 불편함을 넘어, 개발 생산성에도 영향을 주는 문제입니다.특히 Cursor처럼 코드 편집이나 AI 통합 기능이 포함된 앱은 GPU 렌더링 성능 저하의 영향을 크게 받습니다.🧠 결론macOS 26 “Tahoe”에서 Electron 기반 앱이 느려지는 현상은 일시적인 호환성 문제로,Electron 최신 버전으로의 업데이트를 통해 대부분 해결될 수 있습니다.하지만 사용자는 직접 이 문제를 해결할 수 없고, 각 앱 개발자들의 패치 릴리즈를 기다려야 하는 상황입니다.macOS “Tahoe” 사용자라면, 위 사이트(shamelectron)를 참고해사용하는 앱의 업데이트 여부를 수시로 확인해보시길 권장합니다.
1.7K
1
0
Xcode 16.3에서 발생하는 문제와 Xcode 다운그레이드 방법
❗️ Xcode 16.3 버전 문제현재 Xcode 16.3에서 React Native 앱 빌드 시 undefined template 'std::char_traits<unsigned char>' prevent building the app 오류가 난다는 보고들이 여기저기서 올라오고 있습니다.애플은 macOS와 Xcode를 자주 업데이트합니다만, 이 업데이트가 항상 개발자들에게 좋은 소식만은 아닙니다.Xcode가 새롭게 업데이트되면 다음과 같은 문제가 생길 수 있습니다:이전에 잘 되던 빌드 오류 발생서드파티 라이브러리 호환 문제Flutter, React Native, Unity 등 툴체인과 충돌macOS 시스템 요구사항 때문에 이전 버전 설치 불가🔧 해결 방법은? Xcode 버전 다운그레이드!가장 확실한 해결책은 안정적으로 사용하던 이전 버전 Xcode로 되돌리는 것입니다.1. 이전 버전 Xcode 다운로드애플의 공식 개발자 사이트에서 원하는 버전의 Xcode를 다운로드할 수 있습니다.👉 Apple Developer - More Downloads로그인 후 Xcode를 검색하면 다양한 버전의 Xcode .xip 파일을 받을 수 있습니다.지금은 16.3 버전이 문제이므로, Xcode 16.2 버전을 다운로드 받으면 되겠습니다.2. 기존 Xcode 삭제기존 Xcode는 /Applications/Xcode.app에 설치되어 있으므로, 아래 명령어로 삭제 가능합니다:sudo rm -rf /Applications/Xcode.app 또는 Finder에서 직접 Xcode.app를 휴지통에 버리셔도 됩니다.3. .xip 파일 설치다운받은 .xip 파일을 더블 클릭하면 자동으로 압축이 풀리고 Xcode.app 파일이 생성됩니다. 해당 앱을 다시 /Applications 폴더로 옮겨주세요.4. Xcode 버전 설정터미널에서 아래 명령어를 입력하면, 시스템에서 사용할 기본 Xcode 버전을 설정할 수 있습니다:sudo xcode-select -s /Applications/Xcode.app /Applications/Xcode.app는 새로 설치한 Xcode 위치에 따라 다를 수 있습니다.5. Xcode 버전 확인아래 명령어로 현재 설정된 Xcode 버전을 확인할 수 있습니다:xcodebuild -version ✅ 추가 팁: 여러 Xcode 버전 동시에 설치하기만약 여러 프로젝트에서 다른 버전의 Xcode를 사용해야 할 경우, Xcode_13.4.1.app, Xcode_15.0.app 식으로 이름을 다르게 하여 /Applications 폴더에 두고, 필요할 때마다 xcode-select 명령어로 전환하면 됩니다.sudo xcode-select -s /Applications/Xcode_13.4.1.app 마무리하며Xcode는 애플 개발의 필수 도구이지만, 버전 변화가 프로젝트에 영향을 줄 수 있습니다. 항상 업데이트 전에는 호환성 여부를 확인하고, 문제가 생겼을 때는 다운그레이드를 통해 빠르게 복구할 수 있도록 대비해두세요.
2.7K
2
0
운영자·2025-08-10
aaa
AI 공부를 시작하는 당신을 위한: MCP와 RAG 쉽게 이해하기
AI 시스템을 공부하거나 실무에 적용하고 싶은 분들을 위해 두 가지 중요한 개념을 쉽게 정리해보았습니다. 바로 MCP (Model Context Protocol)와 RAG (Retrieval-Augmented Generation)입니다.이 두 용어는 AI 모델, 특히 LLM(대형 언어 모델)을 활용할 때 자주 언급되는데요, 얼핏 보면 비슷해 보일 수도 있지만, 실제로는 다른 목적과 역할을 가지고 있습니다.먼저, RAG가 뭔가요?RAG란?RAG는 Retrieval-Augmented Generation의 줄임말이에요. 말 그대로 검색을 통해 생성(Generation)을 보강한다는 의미입니다.쉽게 말해,LLM(예: ChatGPT)는 훈련된 범위 내에서만 대답을 할 수 있죠.하지만 최신 정보, 외부 데이터까지 알려면 어떻게 해야 할까요?바로, 외부에서 정보를 검색해서 LLM이 답변에 활용하게 만드는 것!이게 바로 RAG의 핵심입니다.RAG의 기본 구조사용자가 질문을 입력하면,외부 데이터베이스(예: 검색엔진, 벡터 DB, 문서 저장소)에서 관련 정보를 찾아옵니다.찾은 정보를 LLM에 전달하고,LLM은 이 정보를 활용해서 보다 정확하고 구체적인 답변을 생성합니다.예를 들어 "2024년 삼성전자 실적 알려줘"라고 물었을 때,GPT는 훈련 데이터에 최신 실적이 없지만,RAG 구조에서는 DB에서 최신 실적 데이터를 찾아와 답변에 반영합니다.RAG는 어디에 쓰일까요?챗봇고객센터 자동화기업 내부 문서 검색 및 요약AI 비서그럼, MCP는 뭐지?MCP란?MCP는 Model Context Protocol의 약자입니다.RAG가 LLM 중심의 구조라면, MCP는 다양한 AI 모델들이 서로 정보를 주고받는 '언어' 또는 '규칙'이에요.왜 필요할까요?AI 시스템을 만들다 보면 LLM 외에도 다양한 모델이 함께 일하는 경우가 많아요.예: 대화 모델, 추천 모델, 이미지 분석 모델 등.이 모델들이 각자 동작은 잘하지만, 서로 컨텍스트(상황, 세션 정보 등)를 어떻게 주고받을지는 명확하지 않아요.그래서 등장한 개념이 바로 MCP입니다.MCP의 핵심 역할모델 A가 유저와 대화 중 얻은 정보를 모델 B, 모델 C와 공유.사용자에 대한 정보, 현재 세션 상태, 사용자의 목적 같은 컨텍스트 데이터를 여러 모델에 전달.결국 여러 모델 간 협업이 원활해지도록 도와주는 통신 규칙 역할.MCP는 어디에 쓰일까요?멀티 에이전트 시스템 (여러 AI가 협력하는 시스템)AI 오케스트레이션 플랫폼 (AI 작업을 자동으로 연결하고 관리하는 시스템)복합 서비스 (챗봇 + 추천 시스템 + 데이터 분석이 통합된 서비스)RAG와 MCP의 관계자, 그럼 궁금해지죠?"RAG와 MCP는 어떤 관계일까?"비슷한 점둘 다 AI가 더 똑똑해지게 돕는 도구입니다.둘 다 컨텍스트를 활용합니다 (유저 입력, 외부 데이터 등).다른 점RAG는 하나의 LLM이 더 똑똑해지기 위해 외부에서 필요한 정보를 검색해오는 구조예요. 마치 LLM이 혼자선 알지 못하는 내용을 외부에서 책이나 문서를 찾아와서 참고하는 것과 비슷하죠. 그래서 주로 LLM + 검색 시스템 조합으로 사용되고, 챗봇이나 문서 요약 같은 곳에서 많이 활용돼요.반면에 MCP는 여러 개의 AI 모델들이 함께 일할 때 필요한 공통된 언어와 규칙이에요. LLM 하나가 아닌, 모델 A에서 얻은 정보를 모델 B, C로 넘겨주고, 각 모델이 서로 협력하면서 더 복잡한 작업을 수행할 수 있도록 도와주는 거예요. 그래서 멀티에이전트 시스템이나 다양한 AI 기능이 연결된 복합 서비스에서 자주 사용돼요.한마디로,RAG는 "LLM이 외부에서 정보를 찾아오는 도구"MCP는 "여러 AI가 서로 대화하며 함께 일하게 해주는 규칙"MCP 안에서 RAG가 쓰일 수도 있어요!실제로 MCP로 여러 모델을 연결한 시스템 안에, RAG가 포함될 수도 있습니다.예시:모델 A (대화 담당)가 사용자 정보를 받아 모델 B(추천 담당)로 전달하면서,그 과정에서 모델 B가 RAG를 호출해 외부 데이터를 검색한 후,최종 추천을 완성하는 식으로요!쉽게 정리하면RAG는 "LLM에게 외부에서 지식 가져와서 알려주는 역할"MCP는 "AI 모델들끼리 서로 말을 잘 통하게 만들어주는 규칙"마무리AI 공부를 막 시작하셨다면, 이런 구조를 한 번에 외우려고 하기보다는 "AI가 어떻게 더 똑똑해지지?"를 고민하면서 RAG와 MCP를 떠올려 보세요.앞으로 AI가 더 복잡해지고 여러 모델이 협력하는 세상이 올수록 RAG와 MCP 둘 다 매우 중요한 개념이 될 거예요!
10.1K
2
0
"이 파일 누가 짰지?" git-who로 팀 협업을 더 재밌고 스마트하게!
개발하다 보면 이런 순간이 자주 찾아옵니다."이 파일 누가 주로 만들었지?""이 서비스 모듈 담당자가 누군가요?""레거시 코드 좀 봐야 하는데, 누가 제일 많이 건드렸는지 궁금하네..."보통은 git blame 이나 git log, git shortlog 같은 Git의 공식 명령어를 사용하죠. 그런데 이 명령어들은 정보를 잘게 쪼개서 주기 때문에 '딱 이 파일에 누가 가장 기여했는지 한눈에 보기 어렵습니다.이럴 때!오늘 소개할 git-who가 큰 도움이 됩니다.바로, 파일에 대한 주요 기여자를 퍼센트로 보여주는 작은 CLI 툴입니다.🚩 git blame vs git-who 차이점git blame은 파일의 각 줄마다 누가 작성했는지를 확인할 수 있는 Git의 공식 명령어입니다. 주로 문제가 발생한 코드에서 "이 줄은 누가 썼을까?"를 확인할 때 사용합니다.반면, git-who는 파일 전체에서 누가 몇 퍼센트나 기여했는지를 비율로 보여주는 도구입니다.쉽게 말해 git blame이 라인 단위로 세세하게 추적하는 것이라면, git-who는 파일 전체의 기여도를 요약해서 보여주는 도구입니다.git blame은 라인별로 작성자를 하나하나 확인할 때 사용하고,git-who는 파일 또는 디렉토리 단위로 주요 기여자와 그 비율을 한눈에 파악할 때 유용합니다.팀에서는 git-who를 활용해 담당자 파악, 코드 리뷰어 추천, 레거시 코드의 책임자 확인 등 다양한 상황에서 쉽게 사용할 수 있습니다.🤔 git blame은 이런 한계가 있어요예를 들어 git blame user_service.py를 하면 이렇게 나옵니다.e5f6a8d1 (Alice 2024-03-19 15:22:10 +0900 1) def get_user():
f67a1bc9 (Bob 2024-03-19 15:23:01 +0900 2) return self.user_id라인별 작성자는 잘 보이지만,"그럼 Alice가 이 파일에 몇 퍼센트나 기여했을까?"를 바로 확인할 수는 없습니다. 직접 손으로 카운트해야 하죠.🏆 그래서 등장한 git-whogit-who는 Python으로 작성된 오픈소스 CLI 도구로, git blame을 내부적으로 실행한 뒤 작성자별로 라인 수를 집계해서 퍼센트로 보여줍니다.사용법은 매우 간단합니다git who user_service.py출력 결과70% Alice
30% Bob와우! 파일의 주요 기여자 비율을 한 번에 확인할 수 있네요.🧩 git-who 실제 활용 꿀팁 5가지1. 코드 리뷰 담당자 추천git who를 통해 가장 많은 기여를 한 사람을 코드 리뷰어로 지정하면 자연스럽게 "내가 많이 짠 코드"를 리뷰하게 되어 품질도 올라갑니다.2. 레거시 코드 관리 지표특정 파일에 누군가 90% 이상 기여했다면? 이 사람만 아는 코드일 가능성이 큽니다.빠르게 지식 공유를 해야 할 타이밍!3. 온보딩 가이드신규 팀원이 "이 모듈 누가 담당했나요?" 물어볼 때, git who 결과를 보여주며 담당자를 객관적으로 소개할 수 있습니다.4. 리팩토링 협의리팩토링 대상 파일에서 상위 기여자 리스트를 뽑아, 사전 협의 및 기술 부채(Tech Debt) 공유를 효율적으로 할 수 있습니다.5. 팀 이벤트에도 활용 가능"누가 이 파일의 지배자인가?"팀 내에서 파일별로 기여도가 가장 높은 사람을 뽑아 개발자 시상식 같은 재미 요소로도 활용 가능!💡 git-who 한계와 커스터마이징 팁📌 문제: 작성자 이름이 잘려요기본 git-who는 John Doe 이름에서 John만 가져오는 이슈가 있습니다.이유는 단순 split 로직 때문입니다.🔧 해결: 정규식으로 보완하기import re
for line in blame_output.split("\n"):
match = re.search(r'\((.*?)\s+\d{4}-', line)
if match:
author = match.group(1)
authors.append(author)
John Doe → John Doe로 제대로 파싱됩니다.⚙️ CI/CD에 자동화로 붙이기 (GitHub Actions + Slack)팀에서 PR이 올라올 때마다 자동으로 주요 기여자를 분석하고 Slack으로 알림까지 할 수 있습니다.예시 Workflowname: Git Who Check
on:
pull_request:
types: [opened, synchronize]
jobs:
git-who-check:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v3
- name: Set up Python
uses: actions/setup-python@v4
with:
python-version: '3.x'
- name: Install git-who dependencies
run: pip install -r requirements.txt
- name: Run git-who on changed files
run: |
for file in $(git diff --name-only origin/main); do
echo "Analyzing $file"
git who "$file" >> who_report.txt || true
done
- name: Notify to Slack
uses: slackapi/slack-github-action@v1.24.0
with:
payload: |
{
"text": "🔍 *Git-Who Report for PR #${{ github.event.pull_request.number }}*\n```$(cat who_report.txt)```"
}
env:
SLACK_WEBHOOK_URL: ${{ secrets.SLACK_WEBHOOK_URL }}Slack 결과 예시:🔍 Git-Who Report for PR #42
services/payment.py
55% Alice
45% Bob
models/order.py
80% Charlie
20% Alice✨ 활용 아이디어 확장danger.js로 PR 코멘트 자동 등록git who 결과를 기반으로 리뷰어 자동 태그 봇 제작팀 내 "이달의 마스터 파일" 선정 이벤트🚀 마무리: git-who는 작지만 강력한 도구입니다!git blame의 아쉬운 부분을 채워주는 git-who.리뷰 문화, 코드 관리, 협업을 더 효율적이고 재밌게 만들어줄 수 있습니다.이제 더 이상 "누가 짰지?"를 고민하지 마세요!
1.5K
1
0

7년 만의 대격변! GIMP 3.0 정식 출시 - 직접 사용해보니
2025년 3월 16일, 드디어 GIMP 3.0이 세상에 공개되었습니다. GIMP 2.10이 나온 게 벌써 2018년이니, 저처럼 오픈소스 도구를 꾸준히 사용해온 분들은 이 순간을 오랫동안 기다리셨을 것 같습니다.사실 저도 개발자로 일하면서 종종 GIMP를 사용해왔는데요. 배너나 간단한 이미지 작업할 때 포토샵 대신 GIMP로 뚝딱 작업하던 기억이 많습니다. 이번 3.0 업데이트는 그런 저 같은 실사용자에게 정말 반가운 소식이에요.GIMP 3.0, 뭐가 달라졌나?이번 업데이트는 ‘진짜’ 새로워졌습니다. 7년간 묵묵히 이어온 커뮤니티와 개발자들의 집념이 느껴지는 버전입니다. GIMP 2.10 이후, GIMP 3.0 개발이 시작된 게 2020년인데, 개인적으로는 중간에 개발이 멈추는 게 아닐까 걱정도 했었거든요.직접 사용해본 결과, 단순히 겉모습만 바뀐 게 아니라 워크플로우 자체가 훨씬 부드러워졌습니다.1. 드디어 ‘비파괴 편집(non-destructive editing)’ 지원!그동안 GIMP를 쓰면서 가장 아쉬웠던 점 중 하나가 필터 적용 후 되돌릴 수 없다는 점이었는데요. 이제 GIMP 3.0에서는 주요 필터를 비파괴적으로 적용할 수 있어서, 나중에 마음 바뀌어도 얼마든지 수정할 수 있습니다. 그리고 캔버스 위에서 바로 실시간으로 미리보기까지 가능하니, 이 부분은 정말 "드디어!" 싶은 기능입니다.2. 파일 포맷 지원 확대이번 버전에서는 BC7 DDS 파일도 지원하고, PSD 파일 내보내기 품질도 대폭 개선되었습니다. 특히 다양한 앱과의 연동이 쉬워졌다는 점이 인상적이에요. 저처럼 Figma나 다른 디자인 툴과 오가며 이미지 작업하시는 분들은 이 부분이 확 체감될 겁니다.3. 자동 레이어 확장이제 캔버스 크기 계산하다 멈칫하는 일이 없습니다. 브러시 툴로 작업할 때, 레이어가 자동으로 확장되어 자연스럽게 그리기만 하면 됩니다. 이런 소소한 개선이 작업 속도를 확 올려줘서 개인적으로 마음에 드는 부분입니다.4. 텍스트 작업이 한층 업그레이드텍스트 작업도 정말 강력해졌어요. 외곽선, 그림자, 입체효과를 자유롭게 주면서도 여전히 폰트나 크기, 스타일을 바로바로 수정할 수 있습니다. 저는 개발하면서 종종 배너 같은 것들을 직접 제작하는데, 이제 GIMP로 충분히 퀄리티 높은 텍스트 디자인이 가능하겠더라고요.5. 다중 레이어 선택 및 그룹 작업드디어 여러 개의 레이어를 동시에 선택하고 한 번에 이동하거나 변형하는 기능이 추가됐습니다. GIMP로 작업할 때 레이어가 많아지면 정말 번거로웠는데, 이번엔 제대로 개선됐어요.6. 고급 컬러 관리컬러 매니지먼트도 한 단계 업그레이드되어, 이제 사진 보정이나 정확한 색상 작업에도 더 믿고 쓸 수 있을 것 같습니다. 특히 웹 작업이나 인쇄물 작업하시는 분들도 환영할만한 변화입니다.7. 최신 인터페이스 적용 (GTK3)UI도 현대적인 GTK3 툴킷으로 재구성되어 눈에 띄게 깔끔하고 세련된 느낌입니다. 확실히 사용성이 좋아졌어요. 개인적으로 다크모드를 자주 쓰는데, 새로운 UI가 다크모드에서도 훨씬 자연스럽게 어울립니다.8. 새로운 GIMP 로고도 공개!마스코트 ‘Wilber’도 새 단장했습니다. 로고가 조금 더 현대적인 느낌으로 바뀌었네요.개인적인 총평업데이트 직후 바로 GIMP 3.0을 설치해 몇 가지 작업을 해봤는데, 확실히 사용성이 훨씬 개선됐다는 느낌을 받았습니다. 포토샵 대비 GIMP를 가볍게 사용하는 입장에서 봤을 때, 이번 버전은 업무에서 충분히 실전용으로 활용할 수 있을 정도로 탄탄해졌다고 느껴졌어요.오픈소스 특유의 가벼움과 자유로움이 매력적인 툴인데, 이제는 실사용성까지 확 올라가서 ‘대안’이 아닌 ‘메인 툴’로도 고민할 수 있을 것 같습니다.
1.8K
1
1
0
케이플·2025-03-18
옷! 내가 좋아하는 Gimp!
React native에서 pod install시 boost 오류날 때 해결 과정
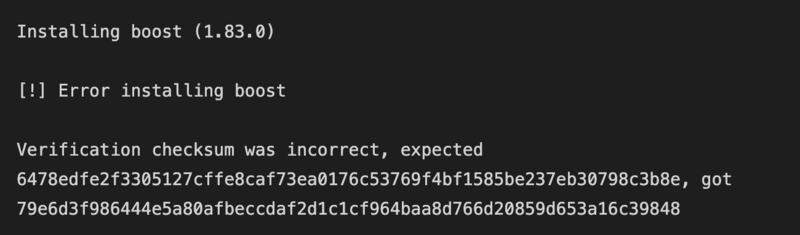
React Native 0.73.1에서 pod install시 다음과 같이 boost 오류가 발생한다.Installing boost (1.83.0)
[!] Error installing boost
Verification checksum was incorrect, expected 6478edfe2f3305127cffe8caf73ea0176c53769f4bf1585be237eb30798c3b8e, got 79e6d3f986444e5a80afbeccdaf2d1c1cf964baa8d766d20859d653a16c39848React Native 버전과 boost 버전이 호환되지 않아서 발생하는 오류 이기때문에라이브러리가 지원하기 전까지는 임시로 해결해야 한다.해결하려면,node_modules/react-native/third-party-podspecs/boost.podspec 파일을 열어서 아래와 같이 되어있는 부분을spec.source = { :http => 'https://boostorg.jfrog.io/artifactory/main/release/1.83.0/source/boost_1_83_0.tar.bz2',
:sha256 => '6478edfe2f3305127cffe8caf73ea0176c53769f4bf1585be237eb30798c3b8e' }아래와 같이 변경한다.spec.source = { :http => 'https://sourceforge.net/projects/boost/files/boost/1.83.0/boost_1_83_0.tar.bz2',
:sha256 => '6478edfe2f3305127cffe8caf73ea0176c53769f4bf1585be237eb30798c3b8e' }그런 다음 다시 pod install를 실행하면 정상적으로 실행 될 것이다.
2.9K
2
0
리눅스 서버에서 원격 접속 터미널 세션 유지하기: tmux 활용법
서버에서 중요한 작업을 수행하던 도중 터미널이 갑자기 끊긴 경험이 있는가? 얼마 전npm install을 실행하고 한참을 기다렸는데, CPU 사용량이 치솟더니 SSH 세션이 강제 종료되어 터미널 접속이 끊겨버렸다. 다시 접속해 보니 작업이 중단되어 있었고, 처음부터 다시 시작해야 하는 상황이었다. 이러한 예상치 못한 터미널 종료는 단순한 불편을 넘어 시간과 생산성에도 큰 영향을 미친다.하지만 이 문제를 해결할 방법이 있다. tmux를 사용하면 터미널 세션을 유지하면서 안정적으로 작업을 수행할 수 있다.1. 세션이 끊기는 주요 사례인터넷 연결이 불안정하여 SSH 연결이 강제 종료되는 경우터미널을 실수로 닫았을 때네트워크 환경이 바뀌거나 VPN이 끊어질 때npm install과 같은 높은 리소스를 요구하는 작업이 서버에서 실행 중일 때장시간 유지해야 하는 작업 도중 터미널이 자동으로 종료될 때이러한 문제를 해결하기 위해 tmux를 사용하면 SSH 세션이 끊겨도 터미널 작업이 계속 실행된다.2. tmux 개념과 기본 사용법tmux란?tmux는 하나의 터미널 내에서 여러 개의 세션을 관리할 수 있는 터미널 멀티플렉서이다. 이를 통해 SSH 세션이 종료되더라도 실행 중인 프로세스를 유지할 수 있다.3.1 tmux 설치대부분의 리눅스 배포판에서 tmux를 쉽게 설치할 수 있다.# Ubuntu / Debian
sudo apt update && sudo apt install tmux
# CentOS / RHEL
sudo yum install tmux
# macOS (Homebrew 사용 시)
brew install tmux3.2 tmux 세션 시작하기tmux위 명령어를 입력하면 새로운 tmux 세션이 시작된다.3.3 세션 분리 (detach) 후 유지하기Ctrl + b, d위 단축키를 누르면 현재 tmux 세션에서 빠져나오면서 세션을 백그라운드에서 유지할 수 있다.3.4 기존 세션 재접속 (attach)tmux attach -t 0 # 세션 번호가 0일 경우만약 여러 개의 세션이 있을 경우 세션 목록을 확인 후 접속하면 된다.tmux list-sessions # 실행 중인 세션 목록 확인
tmux attach -t <세션명>3.5 세션 종료세션이 더 이상 필요 없다면 종료할 수 있다.exit # tmux 세션 내에서 실행또는, Ctrl + b, x를 눌러서 창을 종료할 수도 있다.3. tmux 활용 예제4.1 백그라운드에서 npm install 실행하기tmux new -s install-session
npm install # 패키지 설치 실행
Ctrl + b, d # 세션 분리이렇게 하면 SSH 세션이 끊겨도 npm install이 계속 실행된다.4.2 다중 창 활용하기새 창 만들기: Ctrl + b, c창 간 이동: Ctrl + b, n (다음 창), Ctrl + b, p (이전 창)창 삭제: Ctrl + b, &4. 마무리tmux를 활용하면 SSH 연결이 끊겨도 작업이 지속되므로 서버 관리가 훨씬 안정적이고 편리해진다. 중요한 작업을 수행할 때마다 tmux 세션을 생성하고, 필요할 때 다시 접속하는 습관을 들이면 서버 운영이 더욱 원활해질 것이다. 이제 tmux를 사용하여 SSH 세션 종료 걱정 없이 리눅스 서버를 효율적으로 관리해보자!
2.7K
1
1